AIに手伝ってもらいながら、業務用のアプリをつくる。そんな方が、わりと早い段階でぶつかる壁があります。
「検索しても、欲しい情報が出てこない」
私も、小さな議事録アプリを試しにつくったときに、これにぶつかりました。この記事は、その体験を、技術用語をなるべく使わずにまとめたものです。
こんな場面、ありませんか?
- 先月の会議で「予算を削る」という話が出たはずなのに、「コスト削減」で検索しても出てこない
- 面接の記録から「チームをまとめた経験がある人」を探したいのに、「まとめた」という単語が入っている記録しか出てこない
- 新しく入った人にアカウントを作る話を探して「同僚」で検索したのに、議事録には「新入社員」と書いてあって見つからない
どれも人間が読めば「同じことを言っている」とわかるのに、検索では別物になってしまう。この壁です。
原因:検索は「文字」を探している
多くの検索は、じつは文字が一致するかを見ています。
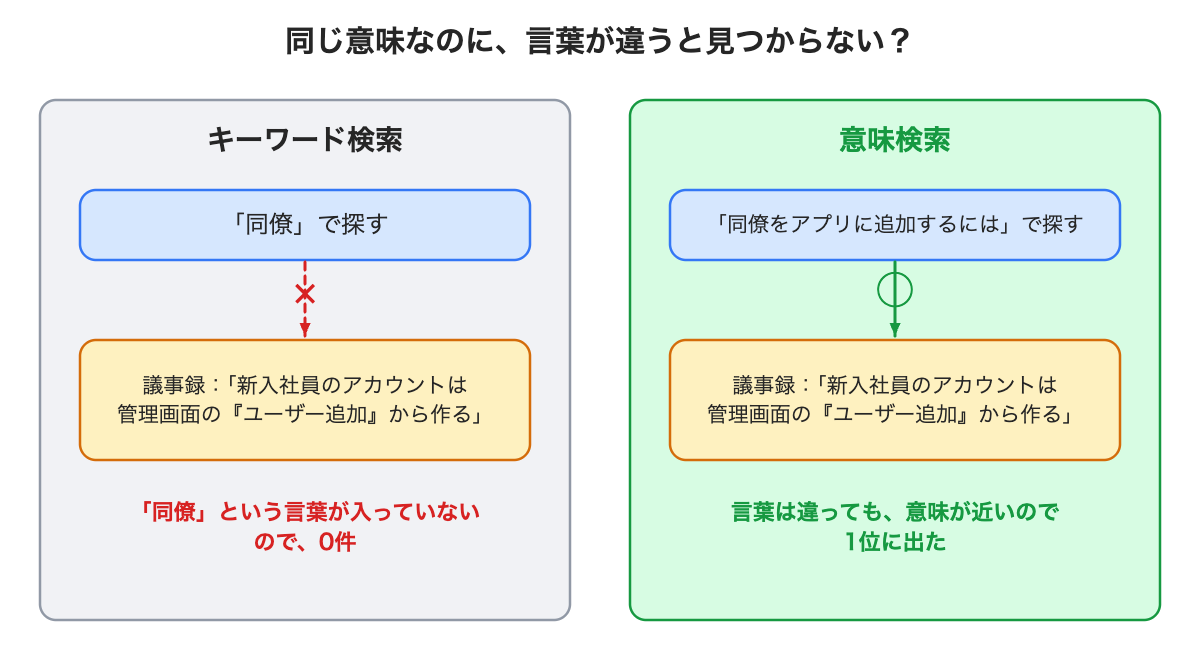
- 「同僚」で探す → 「同僚」という文字を含む記録を探す
- 記録には「新入社員のアカウントは、管理画面の『ユーザー追加』から作る」と書いてある → 「同僚」という文字がないので、見つからない
これがキーワード検索です。文字が合えば強いですが、言い換えに弱い。
解決の考え方:「意味」を探す
そこで出てくるのが意味検索です。名前は難しそうですが、考え方はシンプルです。
文章を「意味の地図」の上に置いて、近くにあるものを探す
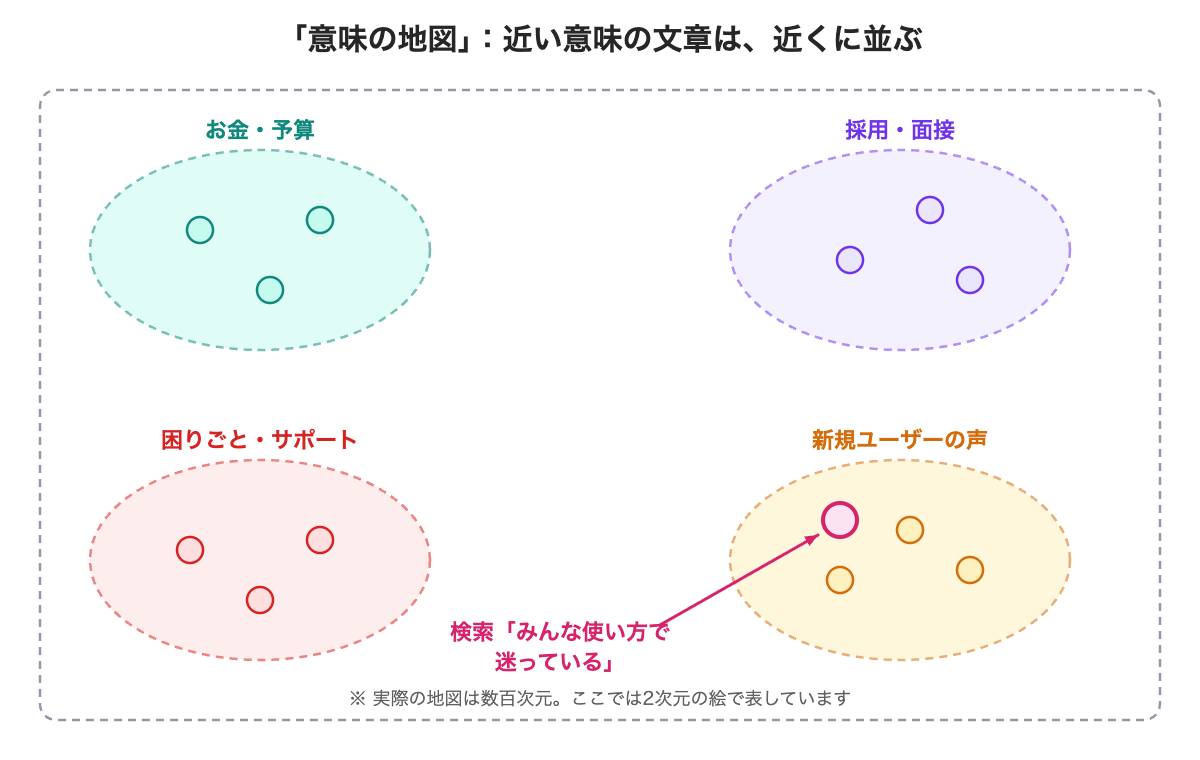
図のように、「お金の話」「採用の話」「困りごとの話」「新規ユーザーの声」は、地図の上でそれぞれの町をつくります。
そして検索する言葉も、同じ地図の上に置きます。「みんな使い方で迷っている」という言葉は、「新規ユーザーの声」の町のすぐ近くに落ちます。そこにいる記録が、近い順に出てくる。これが意味検索です。
たとえるなら、本屋さんの棚の並べ方に似ています。五十音順(=文字で探す)ではなく、「料理」「旅行」「経済」といったジャンルごとに並んでいる棚。「パスタが食べたい」と思ったら、料理の棚の前に立てば、タイトルに「パスタ」と書いていない本にも出会えます。
どうやって「意味」を地図に置くの?
文章を、AIが数百〜千個ほどの数字の並びに変えます(専門的には「エンベディング」と呼びます)。人が意味を書き出す必要はありません。
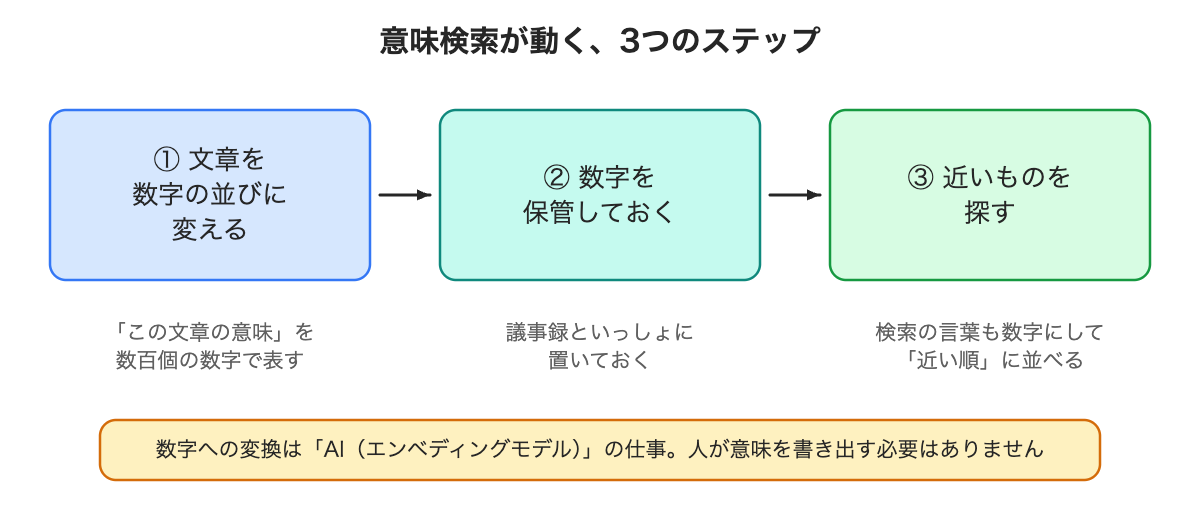
- 文章を数字の並びに変える(AIの仕事)
- 数字を、元の文章といっしょに保管する
- 検索の言葉も数字にして、近い順に並べる
地図の上の「近さ」は、数字の並びが似ているかどうかで測ります。人間の目には数字の羅列にしか見えませんが、コンピュータにとっては「近い・遠い」がすぐ計算できるのです。
小さな実験をしてみました
私は、自分で作った架空の議事録5件と面接メモ3件で、日本語の意味検索を動かしてみました。言葉をわざと変えて、7回検索しました。
| 私が検索した言葉 | 1位に出てきた記録 |
|---|---|
| 「同僚をアプリに追加するには」 | 新入社員のアカウントの作り方の議事録 |
| 「お客さんが離れていく理由」 | 解約が増えた原因を話した議事録 |
| 「チームを率いた経験がある人」 | 5人のチームをまとめた経験を語った面接メモ |
| 「お金の使い道の方針」 | 来期の予算の方針を決めた議事録 |
| 「なぜ転職したいのか」 | 少人数で裁量を持って働きたい、と話した面接メモ |
| 「在宅勤務を希望している人」 | 在宅で働けるかを何度も確認していた面接メモ |
| 「システムが止まった原因と対策」 | 障害の原因と再発防止を話した議事録 |
7回とも、1位は私が「これだよね」と思っていた記録でした。検索した言葉と記録の中身で、同じ単語はほとんど使われていません。
同じ言葉をふつうの「文字が含まれているか」の検索で試すと、7つの言葉のうち6つが0件でした(1つだけ「原因」という単語が一致して2件ヒット)。ここは、体験としてかなり違いました。
ただし、これはたった8件の実験です。件数が増えたとき、本物の議事録で試したときにどうなるかは、まだ確かめられていません。
でも、うまくいかないこともありました
ここからが、私にとって一番の学びでした。意味検索は便利ですが、得意・不得意がはっきりしています。
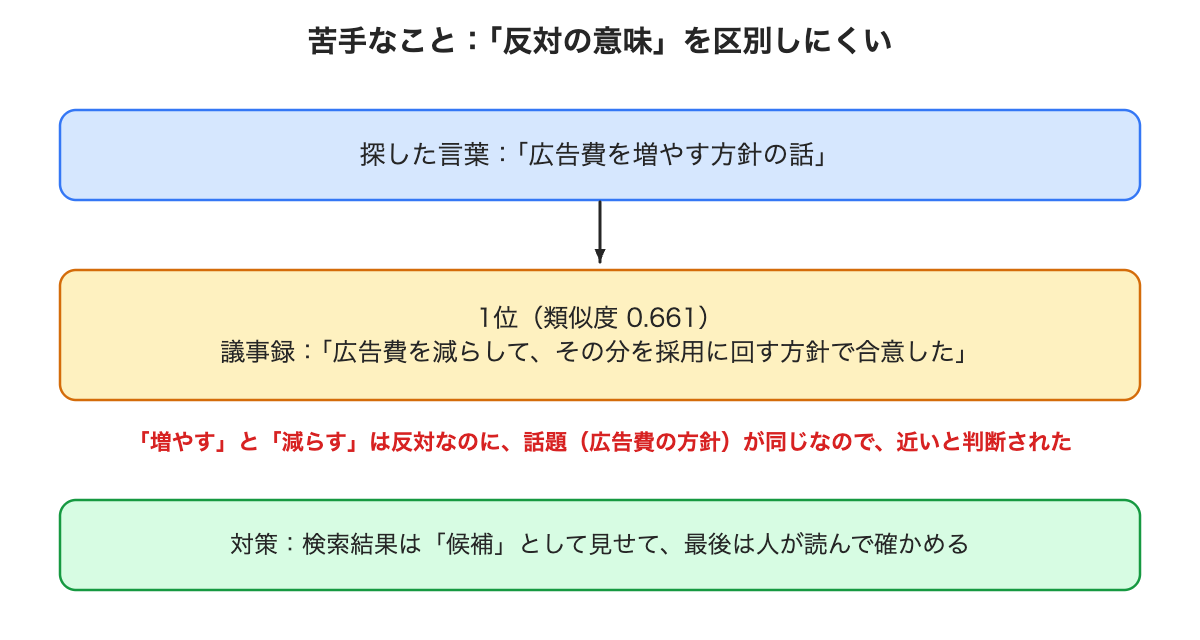
① 反対の意味を区別しにくい
「広告費を増やす方針の話」と探したら、1位は「広告費を減らして、その分を採用に回す」という議事録でした。しかも、全部の検索の中でいちばん高い点数でした。話題(広告費の方針)が同じだと、意味が反対でも「近い」と判断されるようです。
② 1位と2位が、ほぼ同点になることがある
「ミーティングの日程が延びた件」では、1位と2位の点数がほとんど同じでした(0.627と0.622)。「ミーティング」のような共通の言葉に引っ張られて、別の会議の記録が並ぶことがありました。
③ 関係のない言葉でも、必ず結果が返ってくる
「今日のお昼ごはん」と探したのに、3件の記録が返ってきました。意味検索は「近い順に並べる」だけで、「該当なし」とは言ってくれません。
④ 「ここから上は当たり」という線が引きにくい
当たりの1位の点数は0.5〜0.65あたり、うまくいかなかった検索の1位も0.43〜0.66あたりで、重なっていました。「0.5以上なら当たり」のような単純な線では、分けられませんでした(私の8件のデータでの話です)。
ここから私が考えたのは、検索結果は「答え」ではなく「候補」として見せて、最後は人が読んで確かめる使い方が合う、ということです。
意味検索が向いている場面・向いていない場面
| 向いている | 向いていない(キーワード検索のほうが強い) |
|---|---|
| 議事録・面接記録・お客さまの声を「内容」で探す | 型番・注文番号・人名など、一字一句合っていてほしいもの |
| 社内マニュアルから「やりたいこと」で手順を探す | 「この単語を含むものを全部出して」という網羅的な検索 |
| 問い合わせの似たケースを探す | 「増やす」「減らす」のような、反対の意味を厳密に分けたい場面 |
実際の現場では、両方を組み合わせるのが現実的だと感じました。型番はキーワードで、「困りごとの内容」は意味で、といった具合です。
お金と手間の話(先に知っておくと安心です)
意味検索は、「入れたら終わり」の機能ではありません。私が小さな実験で気づいた、お金と手間に関わる点を書きます。
- 文章を数字に変える作業にも、コストがかかることがあります。 外部のAIサービスを使う場合は、使った量に応じて料金がかかるのが一般的です。私は自分のパソコンで動かすモデルを使ったので、お金はかかりませんでしたが、そのパソコンが動いている間しか使えません。仕事で使うなら、常に動いている場所と、その費用が必要です。
- 数字の置き場所も、場所を取ります。 私の実験では、文章1件あたりの「意味の数字」は、約4キロバイトでした。10万件だと、数字だけで約400メガバイトです(これは計算した目安です)。小さな無料の枠だと、意外と早く埋まるかもしれません。
- 失敗した仕事のやり直しにも、回数の料金がかかる仕組みがあります。 自動でやり直す設計にした場合、うまくいかない1件が残ると、何度も呼び出しが発生します。詰まった仕事を見張る仕組みを、最初から考えておくと安心です。
- モデルを変えると、数字の長さも変わります。 保管の準備のやり直しが必要になることがあります。
私の実験は、無料の枠と自分のパソコンだけで収まりました。ただし、これが仕事の規模でも収まるかどうかは、確かめていません。
意味検索を入れる前に、決めておきたい3つのこと
- 何を探したいのか:議事録? 面接? お客さまの声? 探す対象で、向き・不向きが変わります。
- 誰が見ていいのか:意味検索は「見つけやすくする」仕組みです。見ていい人だけに見せるルールは、別に必要です。面接の記録のような個人情報はとくに大切です。また、自分のパソコンや外部のAIサービスに、文章を送ることになる場合は、その文章を外に出してよいかも決めておきます。
- 「当たらない」ときの扱い:さきほどのとおり、意味検索は「いちばん近いもの」を必ず返します。「該当なし」の判断や、人が最後に確かめる流れを、最初から決めておきます。
AIにつくってもらうときの、頼み方のヒント
AIアシスタントにアプリを手伝ってもらうとき、次のように伝えると、意図が伝わりやすいと思います。
- 「議事録を、言い換えても見つかるように検索したい」
- 「新しい議事録を入れたら、自動で検索できる状態にしたい」
- 「検索結果には、近さの目安もいっしょに出してほしい。ただし、『該当なし』のときの見せ方も決めたい」
- 「日本語の文章でちゃんと動くか、日本語のサンプルで確認してほしい」
- 「個人情報を含むので、見られる人を限定したい。文章を外のサービスに送らない構成にしたい」
- 「この方法をずっと動かすと、いくらかかるか見積もってほしい」
こうした「やりたいこと」を言葉にできていれば、細かい仕組みの名前を知らなくても、AIとの会話は進められます。
私が確かめられていないこと
- 本物の議事録・面接記録での精度(今回は自分で作った架空の8件です)
- 数千件以上になったときの、速度とお金
- 別のモデルとの比べ
- 日本語以外の言語での精度(英語で1回だけ試して、うまくいきました)
まとめ
- 検索には、「文字」で探す方法と、「意味」で探す方法がある
- 意味検索は、文章を数字の並びに変えて、近いものを探す。日本語でも、言葉が違う記録に届いた
- ただし、反対の意味・ほぼ同点・「該当なし」が出ないという弱点がある。結果は「候補」として扱う
- お金と手間は、数字に変える作業・置き場所・やり直しの見張りに出てくる
- 小さく試して、自分のデータで確かめるのが、いちばん安心
もし「検索しても出てこない」で困っているなら、まずは数件のデータで試してみるのがおすすめです。「あ、これだ」という感覚は、動かしてみると意外とすぐにつかめます。
もっと詳しく知りたい方へ(技術編・Qiita)
実際に手を動かした記録を、Qiitaに書きました。
Leave a Reply